邮件汇总skill:抓真实邮件、归待办、标需回复
背景与目标
每天邮箱里堆一堆邮件(通知、协作、审批、告警),逐封看完很费时间,还容易漏掉"需要我回复的"。很多做总结的工具会凭空编造——AI 不知道你的邮件内容,就"合理想象"一封。这是邮件类智能体最容易翻车的地方。
这个 skill 的解法很朴素:先用 Python 脚本通过 IMAP 把真实邮件抓回来,再让 AI 只对抓取到的内容做整理。抓取是"事实来源",总结是"在事实之上的加工"。这样输出的每一行都能对应到一封真实邮件,杜绝脑补。
阅读本文你会得到:
一个"抓真实数据 → 结构化汇总"的 skill 通用套路:数据从哪来、怎么保证不编造、输出模板怎么定。
一套能真正跑通的邮件抓取 Python 脚本 实现要点(IMAP 搜索、正文解析、去掉回复链和签名、编码处理)。
一个Windows 上必然踩坑的中文乱码问题及其解法。
步骤
一个"信息盘成清单"的 skill,通常由四块组成:数据来源(抓取)+ 总结规则(显式化)+ 输出模板(结构化)+ 平台坑(编码/执行)。
1. 定数据来源:绝不脑补
最重要的一条:AI 不能自己编造邮件内容。skill 里明写"绝不猜测或虚构邮件内容——始终运行脚本拉取真实邮件,再对实际收到的内容进行总结"。
抓取靠一个纯 Python 标准库脚本(scripts/mail_fetcher.py,无需装任何第三方包)。它通过 imaplib 连登录你的 IMAP 邮箱,按时间段搜索并拉取邮件。核心几个点:
连接鉴权:IMAP over SSL(
imaplib.IMAP4_SSL,端口 993)。Gmail/QQ/163/Outlook 都能用,但 Gmail/QQ/163 要用应用专用密码(授权码),不是登录密码。按时间段搜索:
M.search(None, '(SINCE "..." BEFORE "...")')一次性把范围内邮件 ID 拿回来,再逐封M.fetch(id, "(RFC822)")取全文,按解析出的真实日期二次过滤,避免服务器时区误差。解析正文:
email模块解析 multipart,优先取text/plain,没有才解析text/html(把<br>、块级标签转成换行再剥标签)。降噪:去掉回复链(
-----Original Message-----、>引用行、中文"在...写道")和签名(--)——这些是 AI 总结时最容易当成正文的噪音。
脚本支持几种运行方式,按需取:
python mail_fetcher.py --today            # 今日邮件
python mail_fetcher.py --days 3           # 最近 3 天
python mail_fetcher.py --since 2026-10-20 --until 2026-10-28   # 指定日期范围
python mail_fetcher.py --today --max 30   # 限制数量,防输出过大
python mail_fetcher.py --today --json     # 输出原始 JSON,方便程序化处理
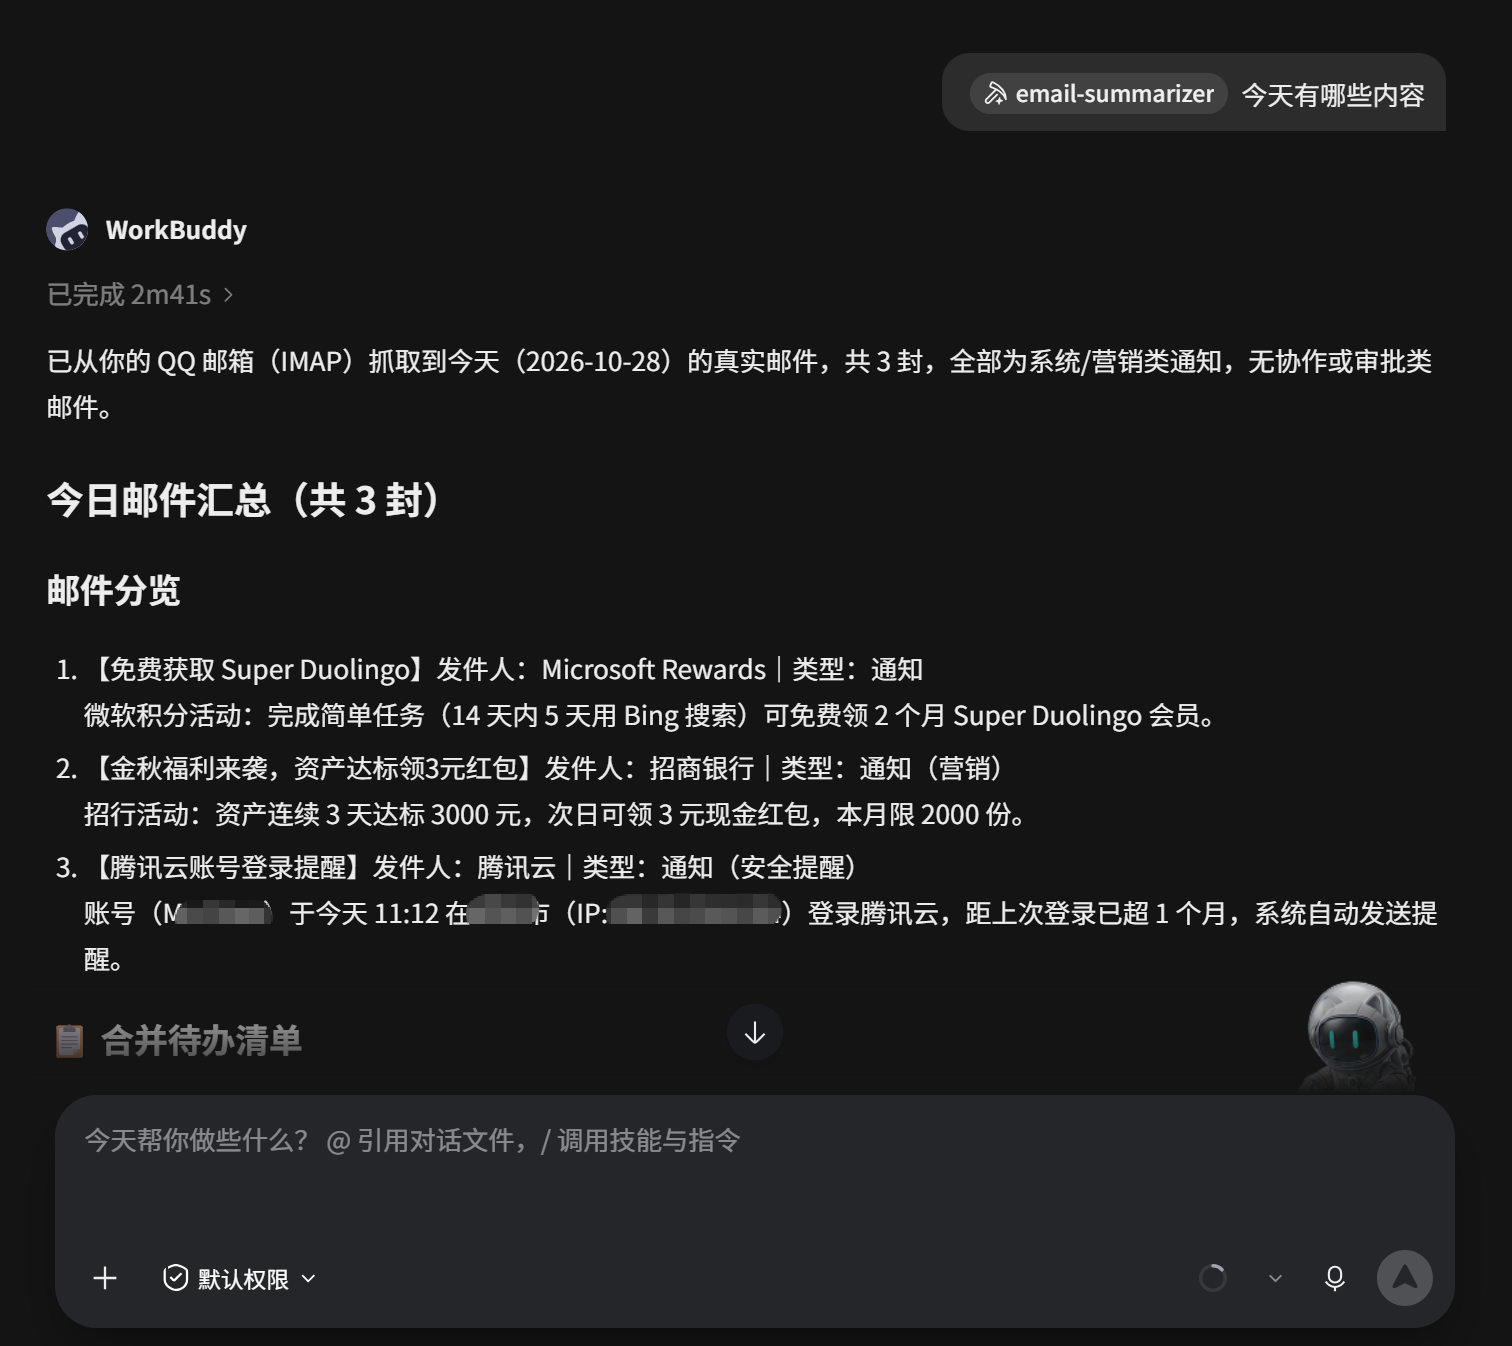
脚本输出的实际效果(Windows 下记得按后面"踩坑第 3 条"处理编码):把截图放到文章同目录的 img/ 里,用相对路径引用:
2. 列总结规则:把"值得保留什么"讲明白
AI 总结容易做两件事:照抄原文,或者自作主张加格式。所以规则一条条写死。以邮件汇总为例,最要命的是这几类:
先总览:先说明共多少封,把每封归为 通知 / 协作请求 / 问题告警 / 审批 四类之一。
逐封精简摘要:每封一行,不照抄原文,去掉签名、历史引用和客套话,只留"讲了什么、关键点是什么"。
合并待办清单:把散在各封里的待办汇总,区分"我方待办"和"他人待办",每项注明责任人、截止时间、交付物。
禁止脑补:截止时间若原邮件没给就写【未指定】,绝不编造——这是"事实来源"原则的延伸,AI 会把"感觉应该是"的时间当成真的。
3. 定输出模板:模板写进 SKILL.md
给 AI 一个固定的、可复现的输出模板,它才知道"一次到位该长什么样"。模板用 Markdown 结构写好在 SKILL.md 里:
# 今日邮件汇总(共 N 封)
## 邮件分览
1. 【主题】发件人:xxx|类型:xxx
一句话摘要:xxx
## 📋 合并待办清单
- [我方] 事项 | 截止时间 | 交付物
- [他人] 事项 | 截止时间 | 交付物
## ⚠️ 风险与卡点
-
## 💬 需要回复的邮件
- 主题:xxx|回复要点:xxx
## ✅ 无需回复
- 主题:xxx固定模板的价值:每一轮输出结构一致,读者扫一眼就知道去哪看。"需要回复的邮件"单独成段,正好命中这个 skill 的核心痛点——别漏掉要回复的信。
4. 处理平台坑:Windows 中文乱码
这是实际使用中第一个踩到的坑。Python 脚本输出是 UTF-8,但 Windows PowerShell 默认按 GBK 解码子进程输出,导致中文全变乱码。skill 里专门写了一大段"Windows 环境注意事项",三件套缺一不可:
[Console]::OutputEncoding = [System.Text.Encoding]::UTF8
$env:PYTHONIOENCODING = "utf-8"
& "<python路径>" -X utf8 "...\mail_fetcher.py" --today --max 30 | Out-File -Encoding utf8 "<输出文件>"
先设置
[Console]::OutputEncoding为 UTF8(否则>重定向时按 GBK 解码子进程输出);设置
PYTHONIOENCODING=utf-8并给 Python 加-X utf8;用
Out-File -Encoding utf8写文件(PS 5.1 里裸>会写成 UTF-16,且 Read 工具可能误判为二进制)。
把输出写到文件再用工具读取,而不是依赖控制台回显——这是处理编码问题的稳妥做法。
踩坑与解决
1. AI 给"没收到的时间"编造截止时间
问题:输出里出现邮件中根本没写的截止时间。
复现:原邮件只说"请尽快处理",输出却写成"截止 10-28"。
根因:AI 默认会补全"合理"的细节,把直觉当事实。
解决:规则里显式写死"若原邮件没有给出截止时间,写【未指定】,绝不编造截止时间"。把"禁止项"写进规则。
验证:无截止时间的邮件,输出标注【未指定】。给 AI 立边界,防它发挥。
2. AI 凭空"总结"出不存在的邮件
问题:没有抓取到邮件时,AI 自己捏造一封"总结"出来。
复现:今天没邮件(
共 0 封),AI 却输出一封像模像样的汇总。根因:prompt 里没强调"输出必须基于抓取结果",AI 就把"没有数据"当"可以自由发挥"。
解决:工作流固定为"先运行脚本抓取 → 再总结抓取输出中实际出现的邮件",并在规则里写死"输出必须能对应到真实邮件"。抓取失败(凭据错/未配置)时明确报告错误,而不是凭空生成一份汇总。
验证:空收件箱能得到诚实的"共 0 封",登录失败能得到清晰的报错。事实来源不可绕开,脚本是唯一的数据闸口。
3. Windows PowerShell 中文乱码
问题:抓取到的中文邮件在终端里全变乱码。
复现:PowerShell 直接
python mail_fetcher.py --today,中文标题/正文乱成一团。根因:Python 按 UTF-8 输出,PowerShell 5.1 默认按 GBK 解码子进程 stdout,两边编码对不上。
解决:用上面"Windows 环境注意事项"的三件套(设 Console OutputEncoding、
PYTHONIOENCODING=utf-8+-X utf8、Out-File -Encoding utf8),并把结果写入文件用工具读取。验证:中文正常显示且文件可读。跨进程传中文,编码要显式对齐,别信默认值。
4. 把回复链和签名当成了正文
问题:总结里混进了一大段历史引用和邮箱签名。
复现:继承对话的邮件,总结把上一轮的"原始邮件"也当成这封的内容。
根因:抓取正文时没有剥离引用链和签名,AI 分不清哪些是"这封新讲的"。
解决:脚本里用
strip_reply_chain在解析时就去掉-----Original Message-----、>引用行、--签名、中文"在…写道"等标记;同时在备注里提醒总结前再检查是否有重要信息被误删。验证:总结只覆盖"新正文",历史引用不再混入。降噪做在数据层,比在 prompt 里约束 AI 更可靠。
5. 时区 / 日期过滤不准
问题:抓"今天"的邮件,结果多半天的边界不对。
复现:
--today抓到昨天深夜或漏了今天白天的信。根因:IMAP 的
SINCE/BEFORE是按服务器时区的粗粒度过滤,直接信它会有边界误差。解决:脚本先粗搜(
SINCE ... BEFORE ...),再对每封邮件用解析出的Date头做二次精确过滤(把无时区的时间按 UTC 处理再比较),保证落在目标区间。验证:边界日期邮件归属正确。粗过滤拿数据、精过滤定归属,两层都做才准。
小结与参考
一个"信息盘成清单"的 skill 四件套:数据来源(真实抓取,绝不脑补)→ 总结规则(显式化、写禁止项)→ 输出模板(结构化固定)→ 平台坑(编码/执行)。
核心是一条事实来源原则:AI 只能加工"抓取到的事实",不编造邮件、不编造截止时间、空收件箱就诚实说"共 0 封"。
降噪(去回复链、签名)做在脚本数据层,比在 prompt 里约束 AI 更稳。
Windows 上跨进程传中文,编码要显式对齐(UTF-8 + Out-File utf8),别信默认值。
这套骨架可以迁移到任何"把一种原始信息源盘成可执行清单"的场景:工单、告警、公告、审批流。换掉抓取来源和输出模板,方法不变。
参考:
抓取脚本:
scripts/mail_fetcher.py(仅标准库,imaplib/email)配置文件参考:
scripts/config.example.json(IMAP 凭据)Python IMAP 文档:https://docs.python.org/3/library/imaplib.html
Python email 文档:https://docs.python.org/3/library/email.html
附:完整 skill 内容
下面给出这个 skill 的完整内容,便于你把方法论落到自己的版本。代码与目录为原文贴入(config.json 是实际配置、含你的账号凭据,已略去,只保留模板 config.example.json)。
A. 目录结构
email-summarizer/
+-- SKILL.md                 # 技能主体(规则 + 工作流 + 输出模板)
+-- _user_meta.json          # 技能管理元数据(安装来源等,可不看)
+-- evals/
|   +-- evals.json           # 评测样例(验证输出是否符合预期)
+-- scripts/
    +-- config.example.json  # 配置模板(复制为 config.json 后填写 IMAP 凭据)
    +-- config.json          # 实际配置(含你的账号,勿提交/勿外发)
    +-- mail_fetcher.py      # IMAP 抓取脚本(仅 Python 标准库)
B. SKILL.md
---
name: email-summarizer
description: 将邮箱收件箱内容整理成结构化的每日邮件汇总。当用户要求总结、整理、或查看邮件概览时使用——尤其是"总结一下邮件"、"今天收到哪些邮件"、"邮件汇总"、"这是我的邮件列表帮我处理"、"summarize my emails"、"today's emails"、"email digest" 这类表述。本技能通过内置的 Python 脚本从用户的 IMAP 邮箱中抓取真实邮件(**绝不凭空编造邮件内容——必须先抓取真实邮件**),然后整理成带分类、待办清单、风险点和需要回复的邮件汇总。除今日外,也支持抓取指定日期范围。只要涉及邮件(哪怕用户只说"看看我的邮件"或提到整理邮件),都应使用本技能。
compatibility: Python 3.8+,以及支持 IMAP 的邮箱(Gmail/QQ/163/Outlook 均可)。需要在 config.json 中配置 IMAP 凭据(参考 scripts/config.example.json)。仅使用 Python 标准库,无需安装第三方包。
---
# 邮件汇总技能
从用户的 IMAP 邮箱中抓取真实邮件,并整理成结构化汇总。本技能绝不猜测或虚构邮件内容——始终运行内置脚本拉取真实邮件,再对实际收到的内容进行总结。
## 工作流程
1. **配置(仅首次)。** 如果 `scripts/config.json` 不存在,则将 `scripts/config.example.json` 复制为 `scripts/config.json`,并请用户填写:
- `host` / `port` — 用户使用的 IMAP 服务器(Gmail:`imap.gmail.com:993`;QQ:`imap.qq.com:993`;163:`imap.163.com:993`;Outlook:`outlook.office365.com:993`)
- `username`、`password` — 账号凭据;对于 Gmail/QQ/163,建议使用**应用专用密码**(SMTP/IMAP 授权码),而不是账号的登录密码。
- `use_ssl` 在 993 端口为 true。
如果用户尚未配置,应请用户配置,而不是擅自猜测其账号。
2. **抓取邮件。** 确定时间范围,并在脚本所在目录运行以下命令:
```bash
# 今日邮件
python mail_fetcher.py --today
# 最近 N 天
python mail_fetcher.py --days 3
# 指定日期范围
python mail_fetcher.py --since 2026-10-20 --until 2026-10-28
```
如需程序化处理(以防输出过大或异常),可使用 `--json`。邮件较多时可加 `--max N` 限制数量。请阅读脚本打印的输出——那就是总结的素材来源。
3. **总结。** 使用下面的模板和规则整理抓取到的邮件。只能总结抓取输出中实际出现的邮件内容。
## 总结规则
汇总的目的是替阅读者节省时间:去掉噪音、保留重点、让后续动作一目了然、不可遗漏。
1. **先总览。** 说明共收到多少封邮件,并将每一封归类为以下类型之一:通知 / 协作请求 / 问题告警 / 审批。请自行判断,为每封选最贴切的一个类型。
2. **逐封精简摘要。** 每封一行。**不要**照抄原文。去掉签名、历史引用和客套话,只保留这封邮件讲什么、关键点是什么。
3. **合并待办清单。** 汇总所有邮件中的待办事项,并区分:
- 我方待办(用户必须做的事)与他人待办(别人在做的事)
- 每项注明:责任人、截止时间、交付物。若原邮件没有给出截止时间,写【未指定】。绝不编造截止时间。
4. **风险与疑问点。** 汇总所有邮件中属于风险、卡点或待解决的疑问。
5. **需要回复的邮件。** 列出每一封需要用户回复的邮件,并为每一封给出具体的回复要点。
6. **禁止脑补。** 如果内容不在抓取到的邮件里,就不要编造。输出必须能对应到真实邮件。
## 规定的输出模板
每次汇总必须严格使用以下结构:
```
# 今日邮件汇总(共 N 封)
## 邮件分览
1. 【主题】发件人:xxx|类型:xxx
一句话摘要:xxx
## 📋 合并待办清单
- [我方] 事项 | 截止时间 | 交付物
- [他人] 事项 | 截止时间 | 交付物
## ⚠️ 风险与卡点
-
## 💬 需要回复的邮件
- 主题:xxx|回复要点:xxx
## ✅ 无需回复
- 主题:xxx
```
如果请求的不是"今日"而是其他时间范围,请调整标题中的日期(例如 `# 10-20 ~ 10-28 邮件汇总(共 N 封)`)。
## 备注
- 脚本会去掉引用的回复链和签名以降低噪音,但仍在总结前检查抓取到的正文中是否有重要信息被误删。
- 如果抓取失败(凭据错误 / 未配置),应清楚报告错误及用户需要修复的内容——不要凭空生成一份汇总。
- 汇总使用用户使用的语言(若用户用中文,则输出中文)。
## Windows 环境注意事项(重要)
在 Windows PowerShell 中运行脚本时,中文输出极易变成乱码(Python 输出 UTF-8,PowerShell 默认按 GBK 解码)。**必须**用以下方式运行,并将输出写入文件后用 Read 工具读取(不要依赖控制台回显):
```powershell
[Console]::OutputEncoding = [System.Text.Encoding]::UTF8
$env:PYTHONIOENCODING = "utf-8"
& "<python路径>" -X utf8 "...\mail_fetcher.py" --today --max 30 | Out-File -Encoding utf8 "<输出文件>"
```
三个要点缺一不可:
1. 先设置 `[Console]::OutputEncoding` 为 UTF8(否则 `>` 重定向时按 GBK 解码子进程输出);
2. 设置 `PYTHONIOENCODING=utf-8` 并给 Python 加 `-X utf8`;
3. 用 `Out-File -Encoding utf8` 写文件(PS 5.1 中裸 `>` 会写成 UTF-16,且 Read 工具可能误判为二进制)。C. scripts/config.example.json
{
  "host": "imap.example.com",
  "port": 993,
  "use_ssl": true,
  "username": "your_email@example.com",
  "password": "your_app_password",
  "starttls": false
}
提示:发布前请把
config.example.json复制为config.json并填写真实 IMAP 凭据;config.json含账号与密码(或授权码),切勿提交或外发。
D. scripts/mail_fetcher.py
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""从 IMAP 账号按时间段抓取邮件内容。
供 email-summarizer 技能使用。可直接运行,例如:
python mail_fetcher.py --days 1
python mail_fetcher.py --since "2026-10-27" --until "2026-10-28"
python mail_fetcher.py --days 1 --max 30
配置位于本脚本同目录下的 config.json(参考 config.example.json)。
"""
import argparse
import datetime as dt
import email
import email.header
import html
import imaplib
import json
import os
import re
import sys
SCRIPT_DIR = os.path.dirname(os.path.abspath(__file__))
CONFIG_PATH = os.path.join(SCRIPT_DIR, "config.json")
def load_config(path=CONFIG_PATH):
if not os.path.exists(path):
sys.stderr.write(
f"未在 {path} 找到 config.json。请将 config.example.json 复制为 "
"config.json 并填写你的 IMAP 凭据。\n"
)
sys.exit(1)
with open(path, "r", encoding="utf-8") as fh:
cfg = json.load(fh)
required = ("host", "port", "username", "password")
missing = [k for k in required if not cfg.get(k)]
if missing:
sys.stderr.write(f"config.json 缺少必填字段:{', '.join(missing)}\n")
sys.exit(1)
return cfg
def decode_header(value):
if value is None:
return ""
parts = email.header.decode_header(value)
out = []
for raw, enc in parts:
if isinstance(raw, bytes):
try:
out.append(raw.decode(enc or "utf-8", errors="replace"))
except LookupError:
out.append(raw.decode("utf-8", errors="replace"))
else:
out.append(raw)
return "".join(out)
def normalize_subject(subject):
subject = subject.strip()
for prefix in ("Re:", "RE:", "FW:", "Fwd:", "回复:", "转发:"):
if subject.startswith(prefix):
subject = subject[len(prefix):].strip()
break
return subject
def clean_text(text):
text = re.sub(r"\r\n", "\n", text)
text = re.sub(r"[ \t]+", " ", text)
text = re.sub(r"\n{3,}", "\n\n", text)
return text.strip()
def strip_reply_chain(body):
markers = (
"\n-----Original Message-----",
"\n-- \n", # 签名分隔符
"\n__________\n", # 部分签名样式
"\n> ", # 引用/转发行(尽力而为)
"\n在", # 中文移动端回复"在...写道"
)
cut = len(body)
for m in markers:
idx = body.find(m)
if idx != -1 and idx < cut:
cut = idx
return body[:cut].strip()
def html_to_text(html_str):
text = re.sub(r"<br\s*/?>", "\n", html_str, flags=re.IGNORECASE)
text = re.sub(r"<(p|div|tr|li|h[1-6])[^>]*>", "\n", text, flags=re.IGNORECASE)
text = re.sub(r"<[^>]+>", "", text)
text = html.unescape(text)
return clean_text(text)
def get_body(msg):
text_body = ""
html_body = ""
if msg.is_multipart():
for part in msg.walk():
ctype = part.get_content_type()
cdisp = str(part.get("Content-Disposition") or "")
if "attachment" in cdisp:
continue
charset = part.get_content_charset() or "utf-8"
try:
payload = part.get_payload(decode=True)
except Exception:
continue
if payload is None:
continue
try:
data = payload.decode(charset, errors="replace")
except (LookupError, TypeError):
data = payload.decode("utf-8", errors="replace")
if ctype == "text/plain" and not text_body:
text_body = data
elif ctype == "text/html" and not html_body:
html_body = data
else:
ctype = msg.get_content_type()
charset = msg.get_content_charset() or "utf-8"
try:
payload = msg.get_payload(decode=True)
except Exception:
payload = None
if payload:
try:
data = payload.decode(charset, errors="replace")
except (LookupError, TypeError):
data = payload.decode("utf-8", errors="replace")
if ctype == "text/plain":
text_body = data
elif ctype == "text/html":
html_body = data
if text_body:
return clean_text(text_body)
if html_body:
return html_to_text(html_body)
return ""
def attach_metadata(email_id, msg):
subject = normalize_subject(decode_header(msg.get("Subject")))
from_raw = decode_header(msg.get("From"))
m = re.match(r"(.*?)[\s]*<([^>]+)>", from_raw)
if m:
sender = m.group(1).strip().strip('"') or m.group(2)
sender_addr = m.group(2)
else:
sender = from_raw.strip()
sender_addr = from_raw.strip()
date_raw = msg.get("Date") or ""
body = get_body(msg)
body = strip_reply_chain(body)
if len(body) > 20000:
body = body[:20000] + "\n...[已截断]"
return {
"id": email_id,
"date": date_raw,
"sender": sender,
"sender_addr": sender_addr,
"subject": subject,
"body": body,
}
def fetch(cfg, since_dt, until_dt, max_emails):
host = cfg["host"]
port = int(cfg.get("port", 993))
use_ssl = bool(cfg.get("use_ssl", True))
if use_ssl:
M = imaplib.IMAP4_SSL(host, port)
else:
M = imaplib.IMAP4(host, port)
if cfg.get("starttls") and not use_ssl:
M.starttls()
M.login(cfg["username"], cfg["password"])
M.select("INBOX")
since_str = since_dt.strftime("%d-%b-%Y")
before_str = (until_dt + dt.timedelta(days=1)).strftime("%d-%b-%Y")
typ, data = M.search(None, f'(SINCE "{since_str}" BEFORE "{before_str}")')
if typ != "OK":
M.logout()
sys.stderr.write("IMAP 搜索失败。\n")
sys.exit(1)
ids = data[0].split()
if not ids:
M.logout()
return []
ids = ids[-max_emails:] if max_emails and len(ids) > max_emails else ids
results = []
for eid in ids:
try:
typ2, msg_data = M.fetch(eid, "(RFC822)")
if typ2 != "OK":
continue
msg = email.message_from_bytes(msg_data[0][1])
meta = attach_metadata(eid.decode(), msg)
# 按解析后的日期过滤,保证准确
try:
parsed = email.utils.parsedate_to_datetime(meta["date"])
if parsed.tzinfo is None:
parsed = parsed.replace(tzinfo=dt.timezone.utc)
if since_dt <= parsed.replace(tzinfo=None) and parsed.replace(tzinfo=None) <= until_dt:
results.append(meta)
except Exception:
results.append(meta)
except Exception as exc:
sys.stderr.write(f"抓取 {eid} 失败:{exc}\n")
M.logout()
results.sort(key=lambda r: r["date"])
return results
def parse_args():
p = argparse.ArgumentParser(description="通过 IMAP 按时间段抓取邮件。")
g = p.add_mutually_exclusive_group()
g.add_argument("--days", type=float, help="抓取最近 N 天的邮件(例如 1、0.5)")
g.add_argument("--since", help="起始日期 YYYY-MM-DD(默认今天)")
g.add_argument("--today", action="store_true", help="仅抓取今日邮件(同 --days 1)")
p.add_argument("--until", help="截止日期 YYYY-MM-DD(默认等于起始日期)")
p.add_argument("--max", type=int, help="限制返回的邮件数量(保留最新 N 封)")
p.add_argument("--json", action="store_true", help="输出原始 JSON 而非可读文本")
args = p.parse_args()
now = dt.datetime.now().replace(microsecond=0)
if args.today or args.days:
if args.days:
since = now - dt.timedelta(days=args.days - 1)
else:
since = now.replace(hour=0, minute=0, second=0)
since = since.replace(hour=0, minute=0, second=0)
until = now
elif args.since:
since = dt.datetime.strptime(args.since, "%Y-%m-%d")
until = dt.datetime.strptime(args.until, "%Y-%m-%d") if args.until else since
else:
since = now.replace(hour=0, minute=0, second=0)
until = now
# 仅给日期未给时间时,默认到当日 23:59:59
if args.since and not args.until:
until = since.replace(hour=23, minute=59, second=59)
elif args.since:
until = until.replace(hour=23, minute=59, second=59)
elif args.days:
until = now
return args, since, until
def main():
args, since, until = parse_args()
cfg = load_config()
emails = fetch(cfg, since, until, args.max)
if args.json:
json.dump(emails, sys.stdout, ensure_ascii=False, indent=2)
return
print(f"# 邮件({since.date()} ~ {until.date()},共 {len(emails)} 封)\n")
for i, e in enumerate(emails, 1):
print(f"--- {i} ---")
print(f"主题:{e['subject']}")
print(f"发件人:{e['sender']} <{e['sender_addr']}>")
print(f"日期:{e['date']}")
print("正文:")
print(e["body"])
print()
if __name__ == "__main__":
main()E. evals/evals.json
{
  "skill_name": "email-summarizer",
  "evals": [
    {
      "id": 1,
      "prompt": "帮我把今天收到的邮件汇总一下,标出哪些需要我回复的。",
      "expected_output": "结构化邮件汇总,含邮件分览、待办清单、需回复邮件。",
      "files": []
    },
    {
      "id": 2,
      "prompt": "上周我请了三天的假没看邮件,帮我看看上周一到上周五都收到什么了,有没有什么重要的事。",
      "expected_output": "按指定日期范围抓取并汇总,突出重要事项和待办。",
      "files": []
    },
    {
      "id": 3,
      "prompt": "帮我整理一下今天邮件里的待办事项,哪些是别人的、哪些是我的。",
      "expected_output": "合并待办清单,区分我方/他人待办。",
      "files": []
    }
  ]
}
实操贴图
图 1:账号初始化
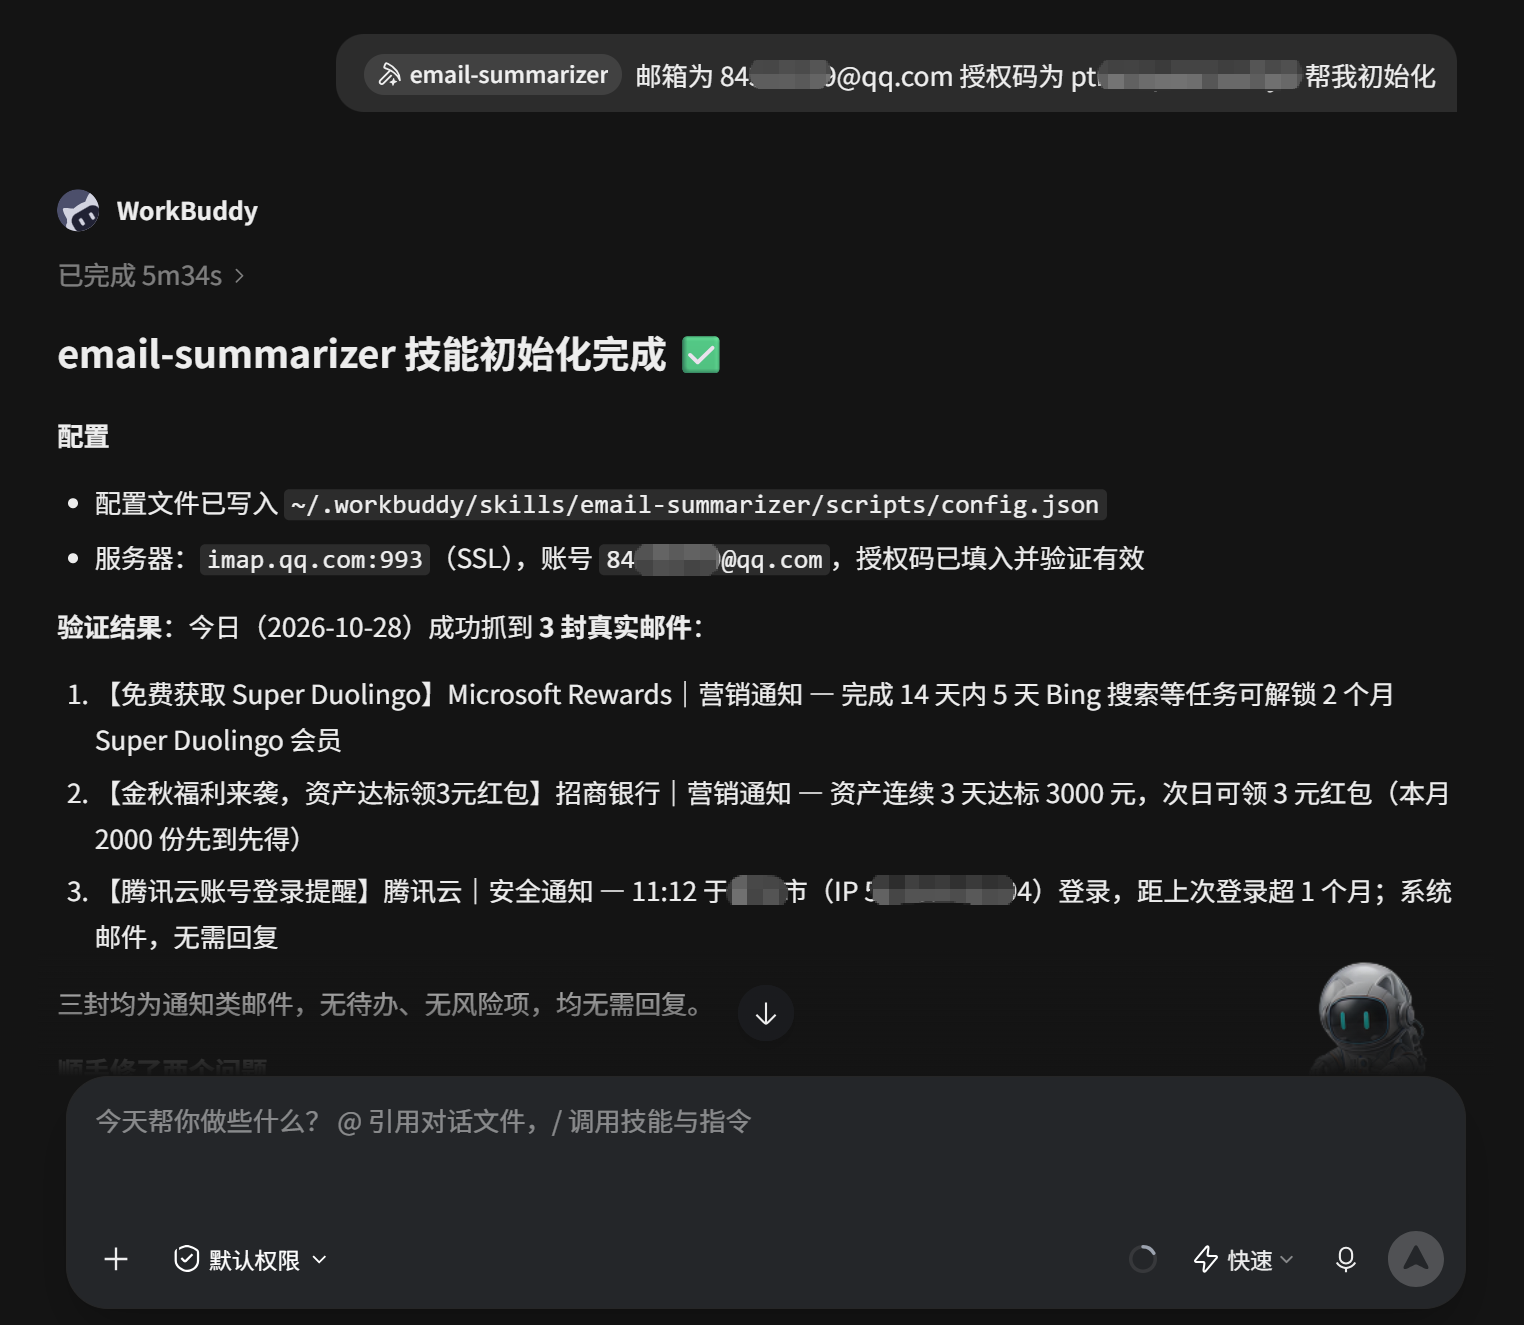
图 2:总结邮件内容